Ejemplo de informe (simulación)
Simulación del modelo: hipótesis sin validar. No es una medición ni una predicción de ventas.
En 3 líneas
- No cumple 2 de 9 condiciones visibles de la pieza.
- En la simulación, la marca casi no se mira de frente y el pico de emoción cae sobre el dato clave.
- Todo es hipótesis del modelo para mejorar el reel: no es una medición ni una predicción.
Reel analizado
No cumple 2 de 9 condiciones de la pieza
Esto revisa lo que se ve en la pieza: qué aparece, cuándo, dónde y si se alcanza a leer. No predice cuántos mensajes o ventas traerá.
La IA cree ver humor o ironía; es una lectura de confianza baja y no entra en ninguna regla.
| No cumple a confirmar | Nada importante debajo de los botones de la plataforma en reels quedan debajo de los botones o textos de la plataforma: la marca «DIOSALUD», el mensaje «¿APLAZAS LA», el mensaje «ORTODONCIA», el llamado a la acción «ESCRIBENOS» Qué hacer: Mueve la marca «DIOSALUD», el mensaje «¿APLAZAS LA», el mensaje «ORTODONCIA» y el llamado a la acción «ESCRIBENOS» hacia el centro del cuadro, para que no queden debajo de los botones o textos de Reels. |
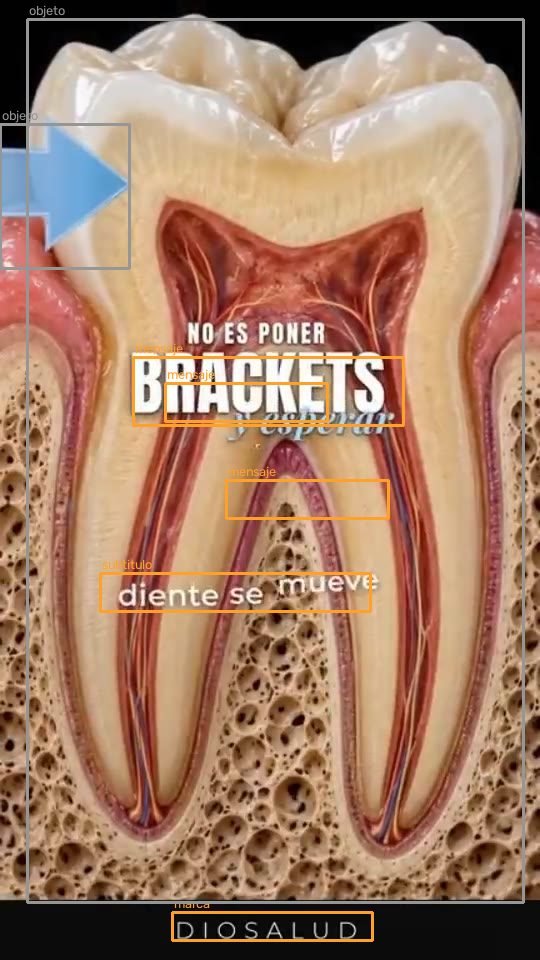
| No cumple a confirmar | Texto importante con buen contraste contraste bajo en el mensaje «por miedo a verte mal?», el mensaje «y esperar», el subtítulo «diente se mueve», el mensaje «fuerzas», el mensaje «CONTROLADAS», el subtítulo «distinto para cada» (el más bajo es 1,8:1; mínimo 3:1 en letra grande y 4,5:1 en letra chica) Qué hacer: Sube el contraste del mensaje «por miedo a verte mal?», del mensaje «y esperar», del subtítulo «diente se mueve», del mensaje «fuerzas», del mensaje «CONTROLADAS» y del subtítulo «distinto para cada», usando texto claro sobre fondo oscuro o al revés, o pon una franja detrás de cada uno, hasta llegar al mínimo de 3:1 en letra grande y 4,5:1 en letra chica (el más bajo hoy está en 1,8:1). |
| Cumple | La marca aparece en los primeros 3 s la marca escrita («DIOSALUD») aparece en el segundo 0,0 |
| Cumple a confirmar | Logo visible y legible no se ve el logo, pero la marca está escrita («DIOSALUD») desde el segundo 0,0 |
| Cumple | Duración permitida por la plataforma dura 35,7 s; reels acepta hasta 180 s |
| Cumple | Algo cambia o llama la atención en los primeros 3 s el mensaje escrito en el segundo 0,4 |
| Cumple | Texto importante de tamaño legible cada línea de texto importante mide al menos el 2,5 % del alto de la pantalla |
| Cumple | Sin tramos largos sin cambios el tramo más largo sin cambios dura 1 s (máximo 5) |
| Cumple | Sin destellos rápidos (más de 3 por segundo) como máximo 1 destello por segundo |
2 reglas que no aplican a esta pieza
| No aplica | Producto visible la pieza no muestra un producto (es un servicio) (servicio) |
| No aplica | Elementos en el segundo pedido no se pidieron segundos |
Línea de tiempo
Cuadros revisados
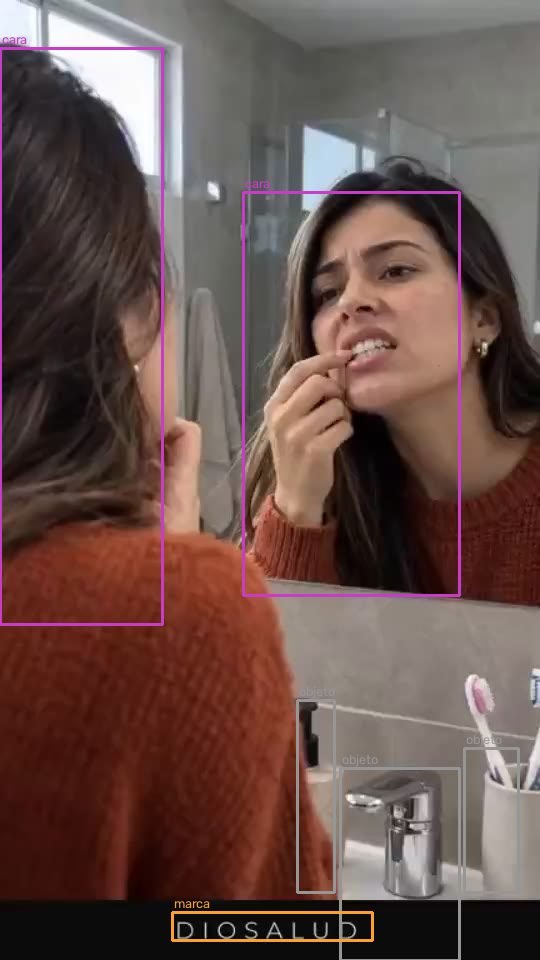
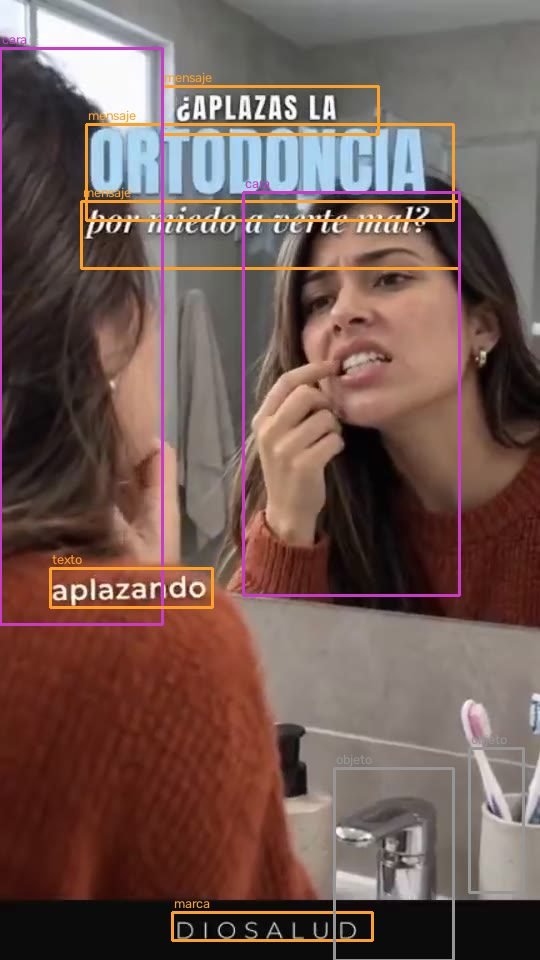
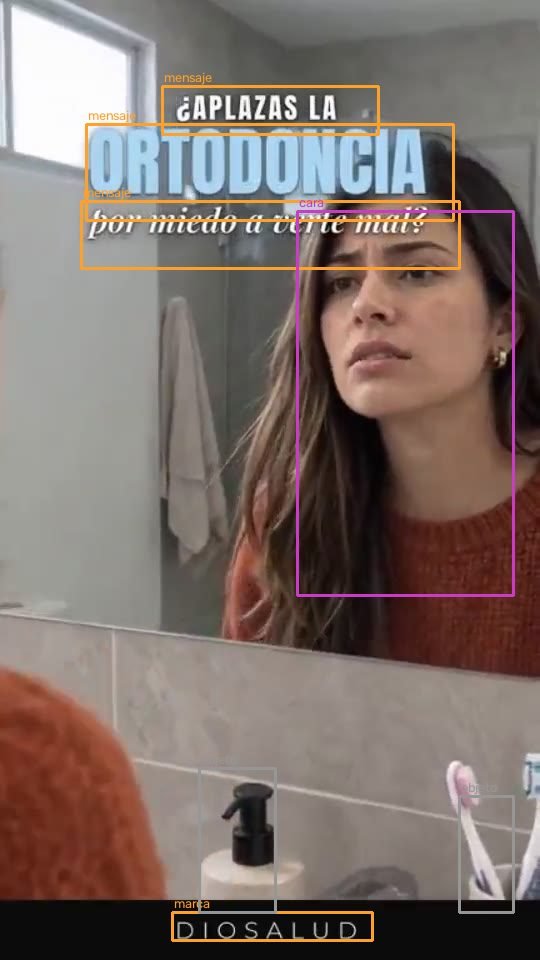
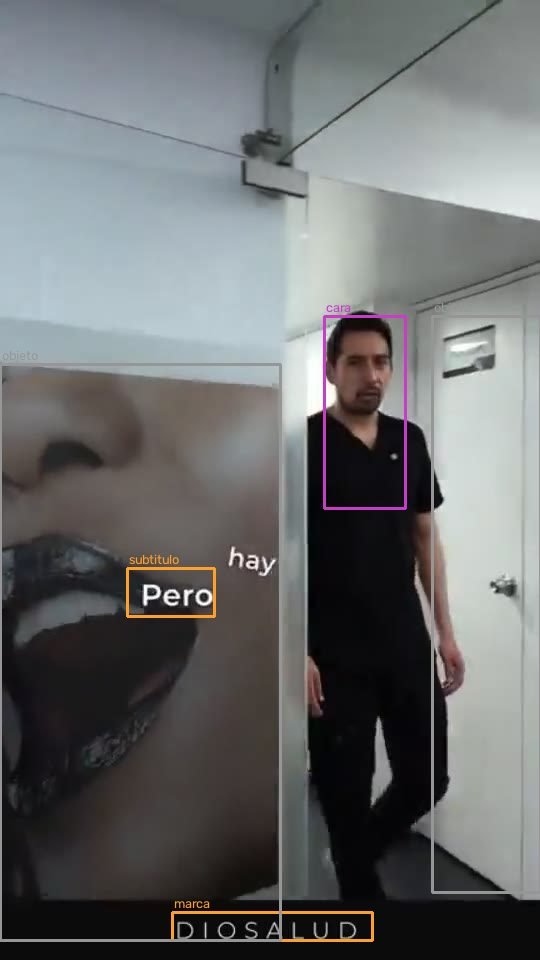
Simulación del cerebro hipótesis, sin validar
Esto es una simulación de un modelo (30 espectadores simulados con reglas de mirada, emoción y memoria). No es una medición en personas y no está validada con resultados reales de Meta: sirve para comparar versiones y para explicar por qué algo podría pasar, no para predecir ventas.
2 de 9 condiciones no se cumplen
2 de 3 criterios predichos no se cumplen
Lo que este modelo no sabe
- La mirada, el abandono y la memoria no están calibrados con ningún registro real: es una hipótesis del modelo, sin calibrar con registros reales.
- Las caras, las emociones y «mira a cámara» salen de pocos cuadros clave descritos por la IA y se suponen iguales hasta el siguiente cuadro clave o corte.
- Los «espectadores» son sorteos del modelo con variaciones inventadas, no una población; con 30, un 50 % tiene un margen de unos 18 puntos.
- La «activación» no es una señal del cerebro ni un EEG: es un número del modelo, sin unidades.
- No hay sonido, edad ni cultura del público en la simulación.
1. Dónde miraron (seguimiento ocular simulado)
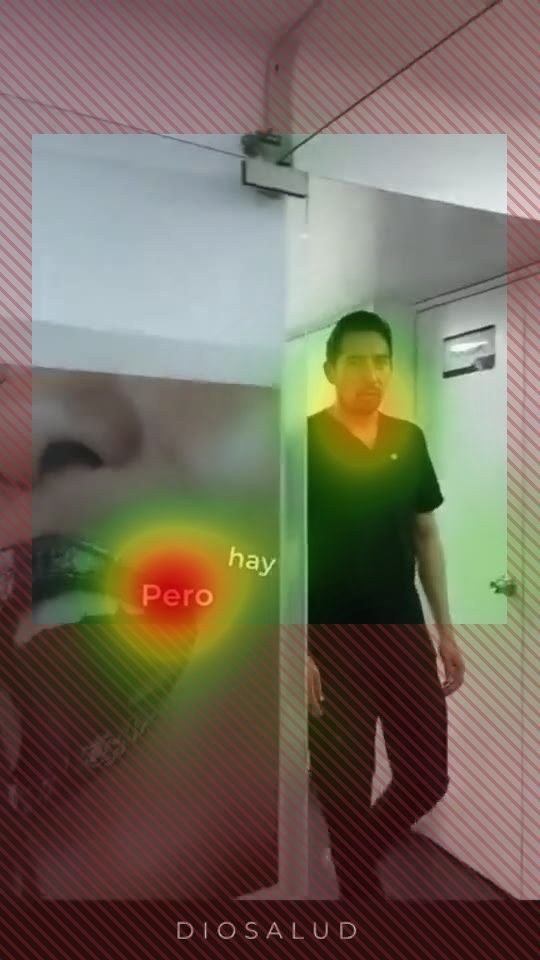
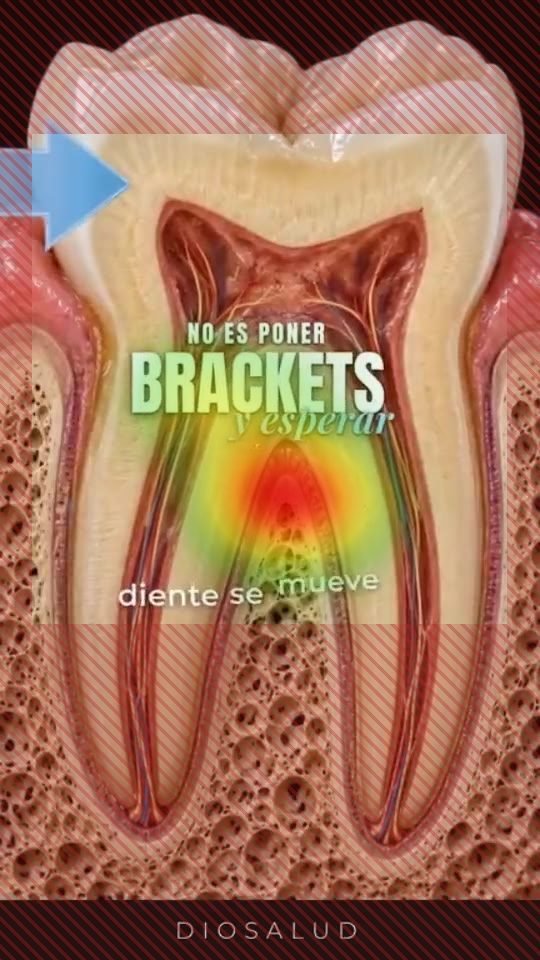
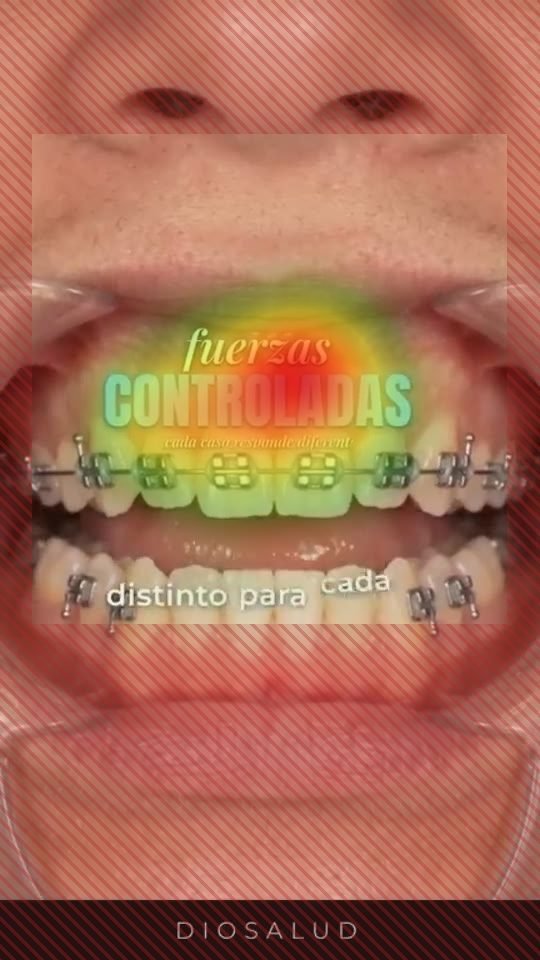
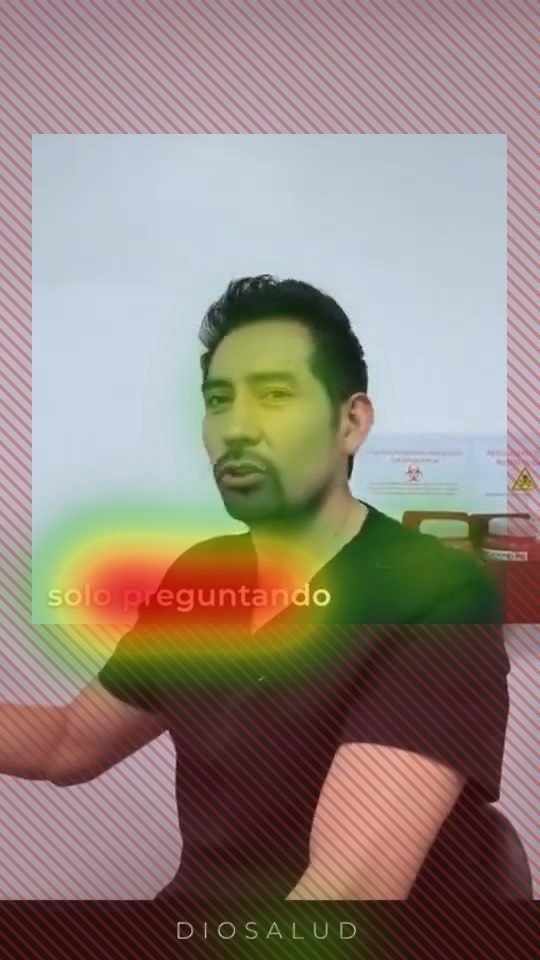
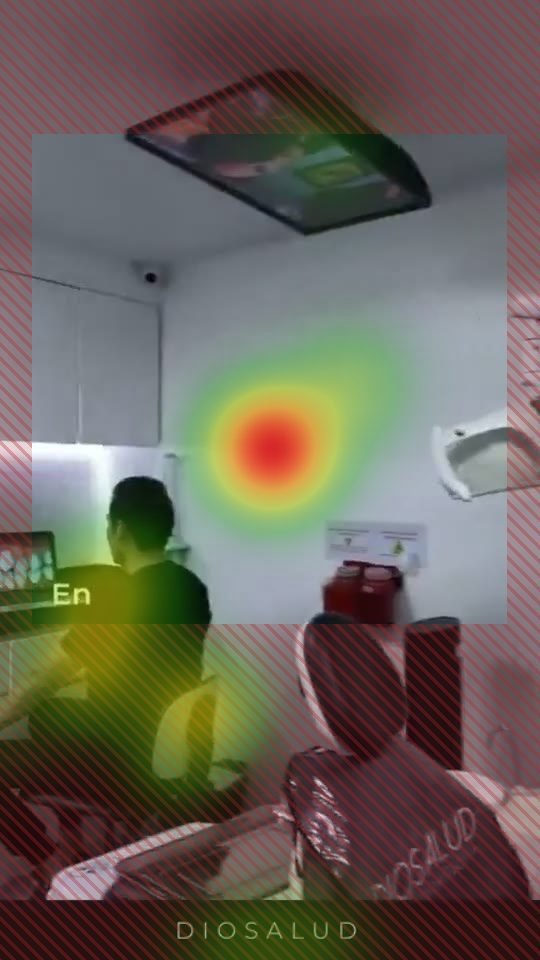
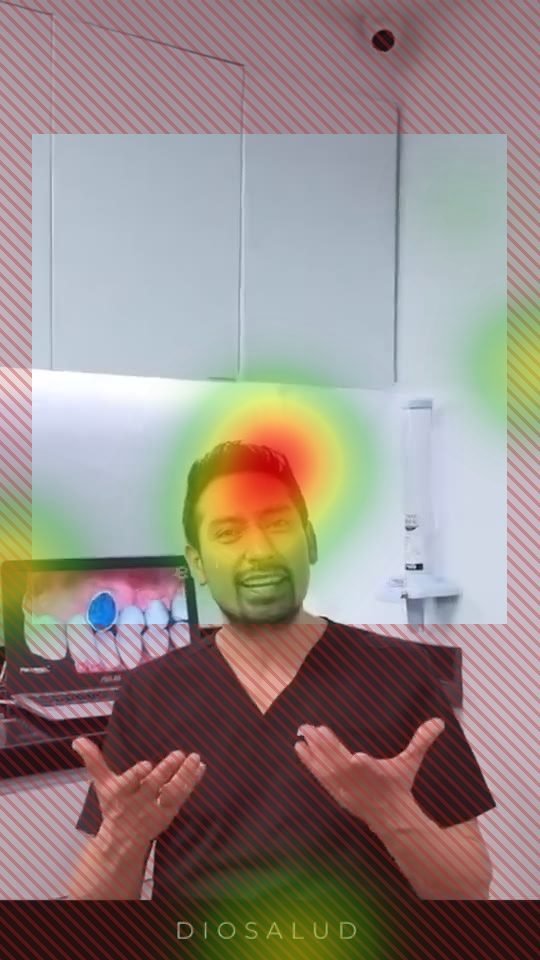
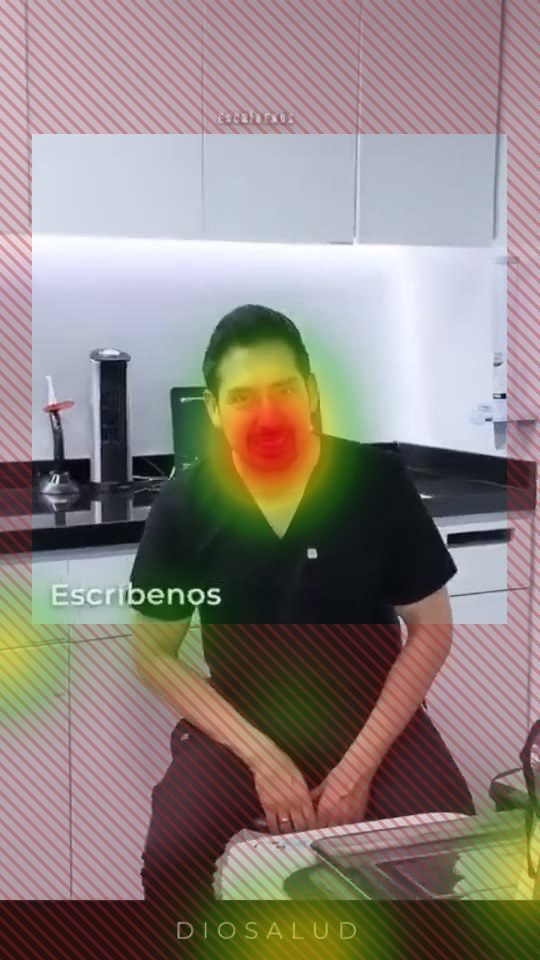
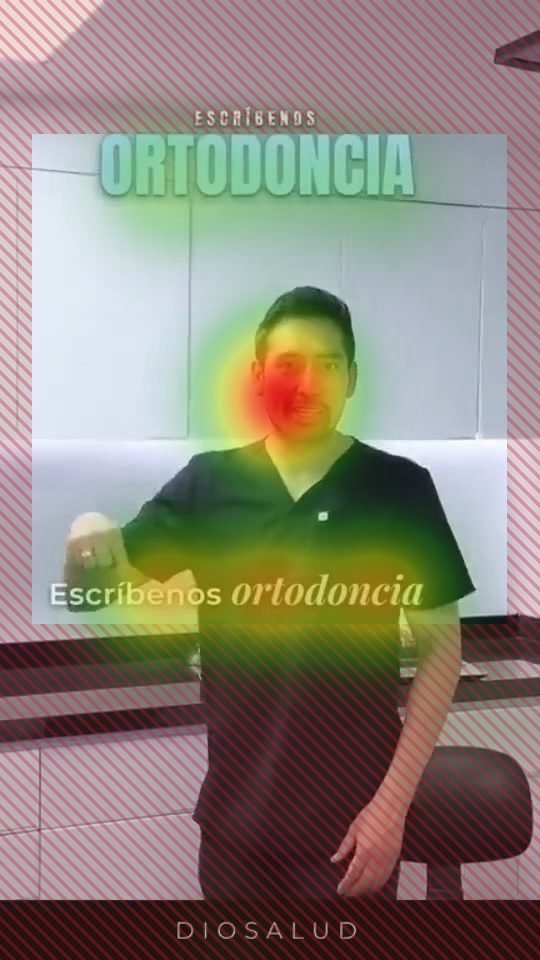
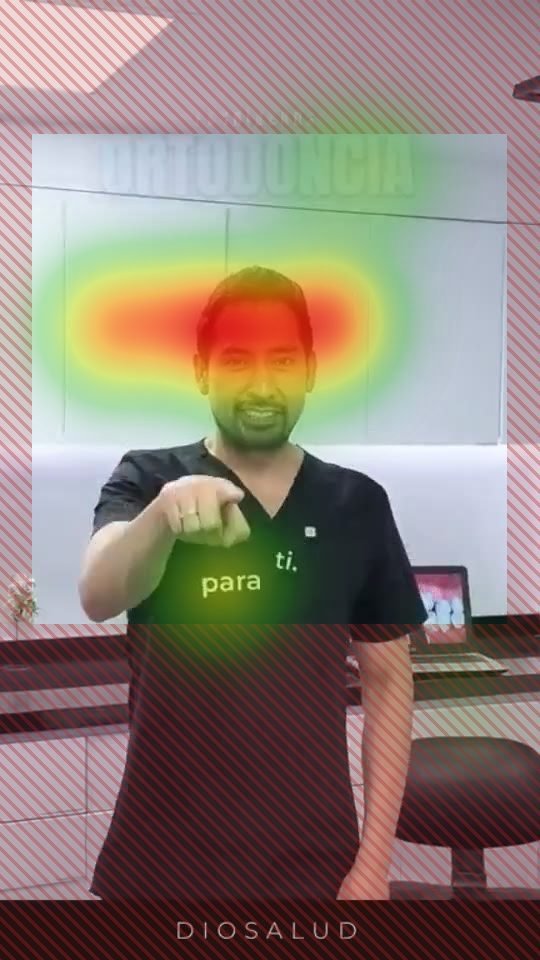
Cada mancha de calor es donde se detuvieron los ojos de los 30 espectadores simulados: rojo es donde más gente miró y más tiempo; verde, poco. Debajo, el calor de cada momento clave (toca la hora para ir a ese segundo del video).
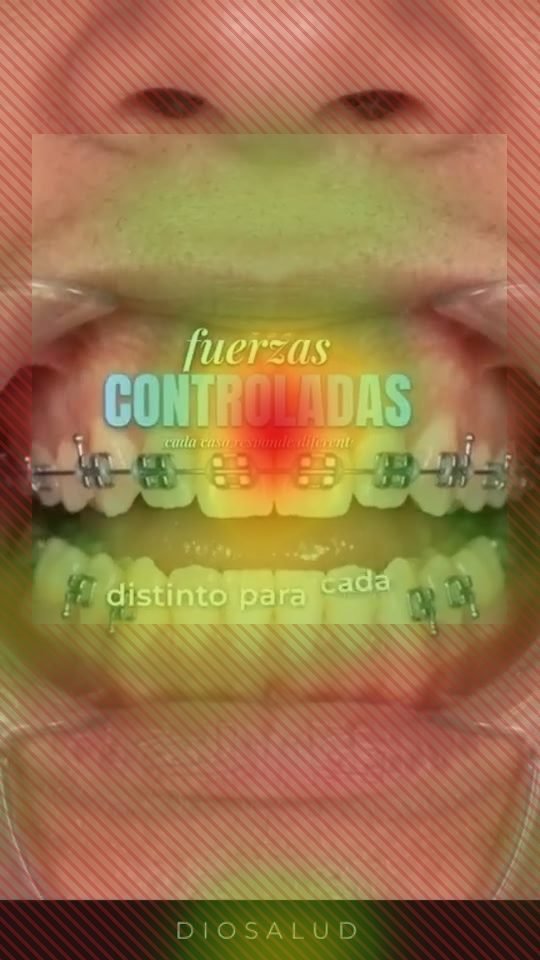
Calor de toda la pieza sobre un cuadro de la mitad. Las rayas rojas son lo que tapa la plataforma.
- 70 % del tiempo de mirada cayó en el tercio central de la pantalla, 13 % arriba y 17 % abajo.
- 22 % cayó en zonas que la plataforma tapa.
- Primera parada de la mirada: 87 % al centro, 13 % a cara. El modelo hace que casi todos miren primero el centro; no está calibrado con ningún registro real de mirada.
- 116 paradas de la mirada por espectador, de 0,28 s en promedio (lo esperable son unas 3 por segundo, de 0,3 s).
- Cómo miraron: 287 de vistazo (mira el centro y capta la escena); 1721 de túnel (se cierra sobre lo que le importa); 1465 de lectura (lee un texto).
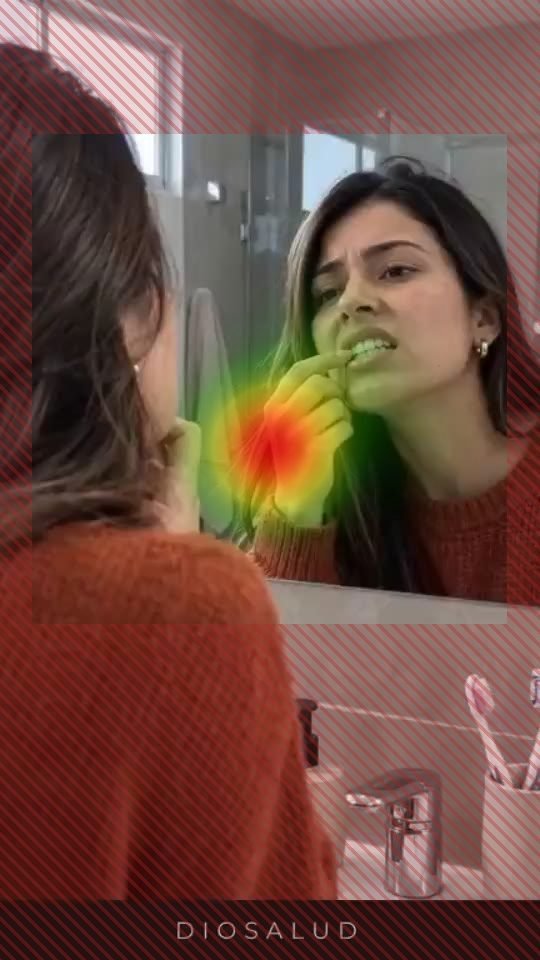
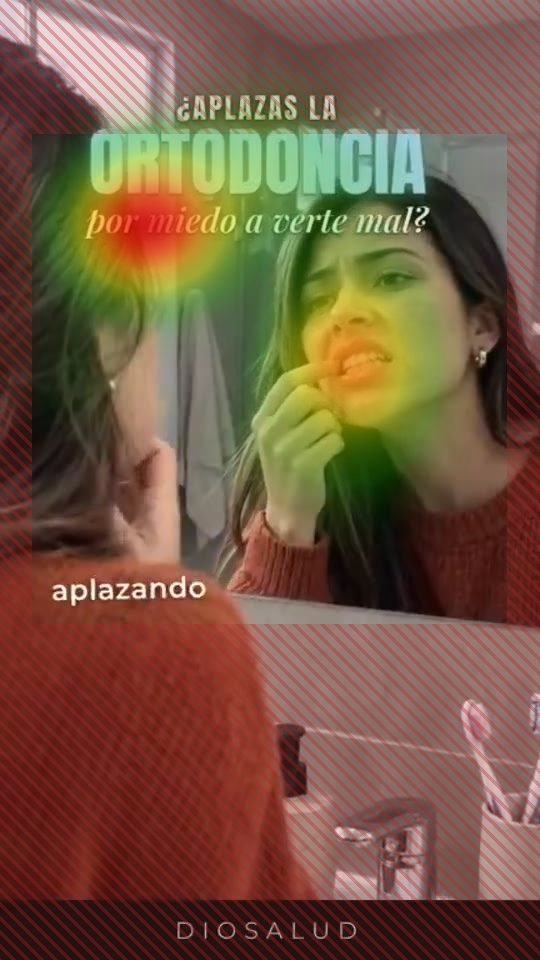
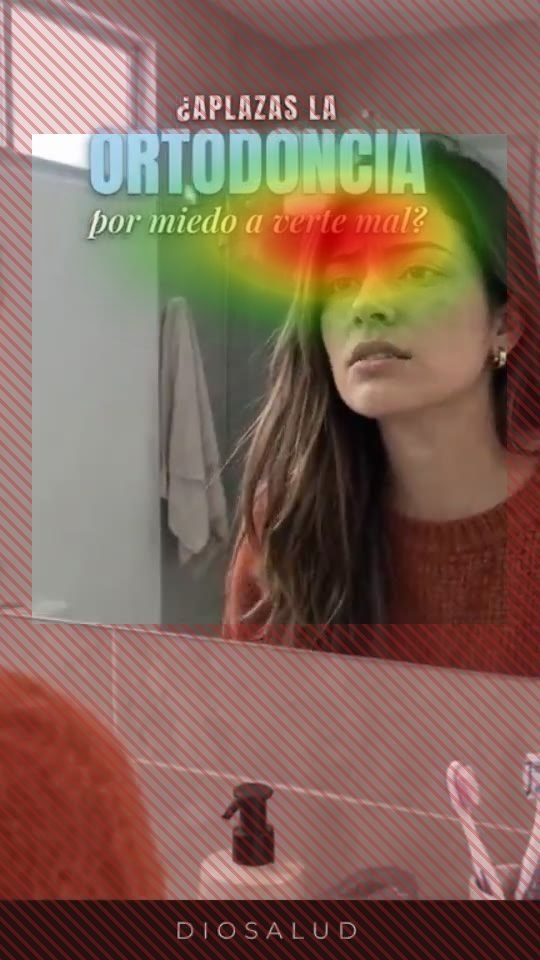
Qué miraron más (de frente) y cuánto leyeron
| Qué | Cuándo | Lo miró de frente | Atención media | Lo leyó |
|---|---|---|---|---|
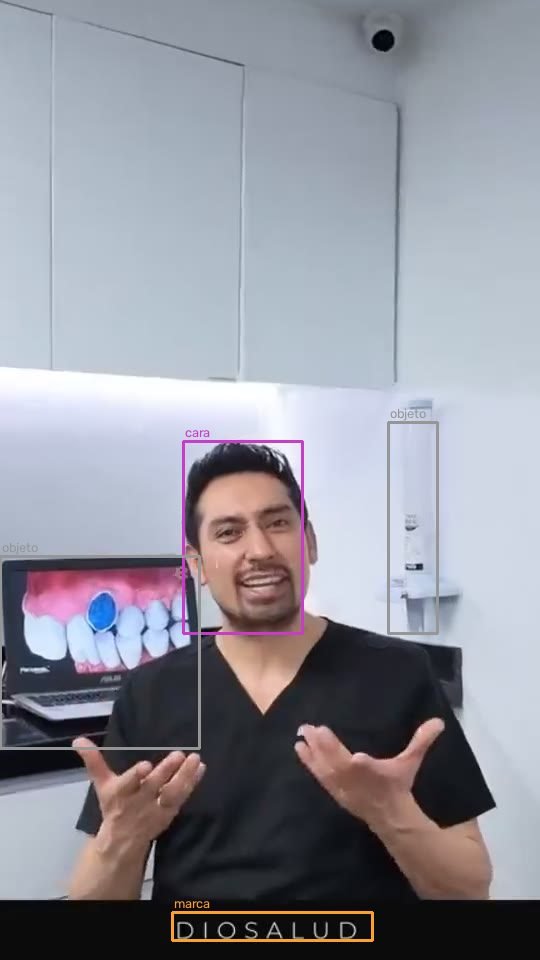
| una cara | 17,9 a 23,2 s | 100 % | 3,5 s | — |
| diente en corte | 9,1 a 12,3 s | 100 % | 3,0 s | — |
| una cara | 0,0 a 3,8 s | 100 % | 2,9 s | — |
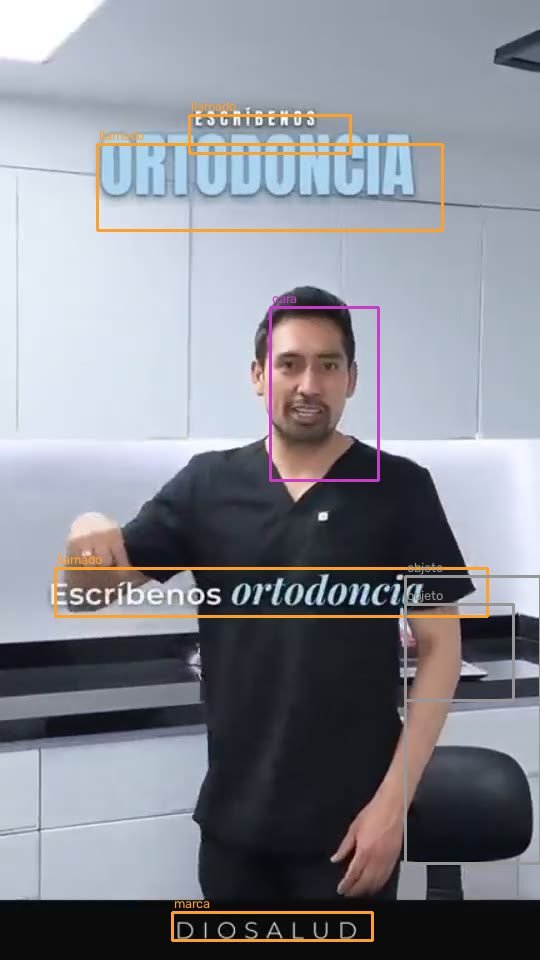
| una cara | 31,5 a 35,7 s | 100 % | 2,7 s | — |
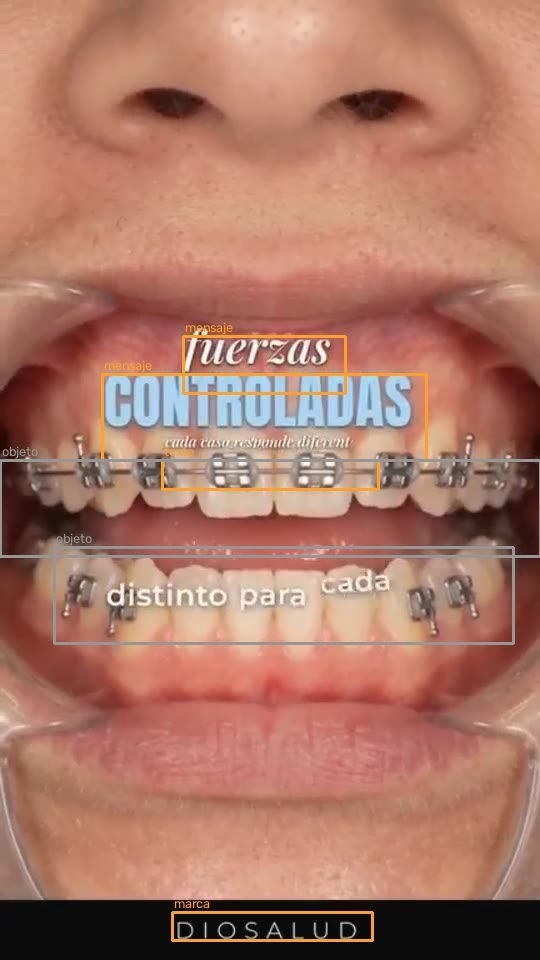
| brackets superiores | 12,8 a 16,3 s | 100 % | 2,7 s | — |
| contenedores rojos de residuos | 17,9 a 23,2 s | 100 % | 2,5 s | — |
| cartel de labios | 3,8 a 7,7 s | 100 % | 2,2 s | — |
| brackets inferiores | 12,8 a 16,3 s | 97 % | 2,1 s | — |
2. Qué estímulos recibió el cerebro
Cada fila es algo que apareció en la pieza, en orden, con las zonas del cerebro que respondieron y qué parte de los espectadores simulados lo miró de frente. Dónde se activó cada zona está en la figura de la sección siguiente.
| Segundo | Qué apareció | Zonas que respondieron | Lo atendió |
|---|---|---|---|
| 2,2 | el mensaje «por miedo a verte mal?» | Palabra escrita, Lenguaje (temporal), Lenguaje (frontal), Relevancia personal | 100 % |
| 2,6 | una cara (molestia) | Mirada y mente ajena, Caras, Emoción y relevancia, Visión | 100 % |
| 4,1 | una cara (seriedad) | Caras, Mirada y mente ajena, Emoción y relevancia, Visión | 83 % |
| 5,3 | un objeto: cartel de labios | Objetos, Visión, Lugares | 95 % |
| 10,0 | un objeto: diente en corte | Objetos, Visión, Lugares | 100 % |
| 13,2 | un objeto: brackets superiores | Objetos, Visión, Lugares | 89 % |
| 13,7 | un objeto: brackets inferiores | Objetos, Visión, Lugares | 84 % |
| 14,7 | el mensaje «fuerzas» | Palabra escrita, Lenguaje (temporal), Lenguaje (frontal), Relevancia personal | 84 % |
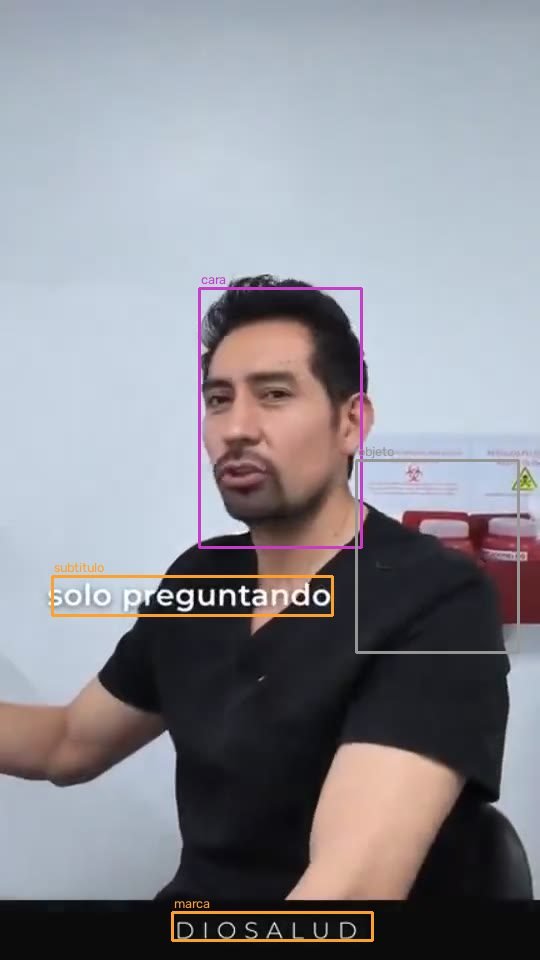
| 20,6 | el subtítulo «solo preguntando» | Palabra escrita, Lenguaje (temporal), Lenguaje (frontal), Visión | 100 % |
| 20,8 | una cara (hablando) | Caras, Mirada y mente ajena, Emoción y relevancia, Visión | 84 % |
| 30,0 | una cara (entusiasmo) mirando a cámara | Caras, Emoción y relevancia, Mirada y mente ajena, Visión | 94 % |
| 32,2 | un movimiento repentino | Movimiento, Campo ocular, Orden de mirar, Atención y números | 85 % |
| 33,4 | el llamado a la acción «Escribenos ortodoncia» | Palabra escrita, Lenguaje (temporal), Acción y manos, Lenguaje (frontal) | 87 % |
| 35,2 | el llamado a la acción «ORTODONCIA» | Palabra escrita, Lenguaje (temporal), Acción y manos, Lenguaje (frontal) | 90 % |
| 35,7 | una cara (sonrisa) mirando a cámara | Caras, Mirada y mente ajena, Emoción y relevancia, Visión | 100 % |
| 35,7 | un movimiento repentino | Movimiento, Campo ocular, Orden de mirar, Atención y números | 100 % |
3. Electroencefalograma del modelo: dónde se activó el cerebro (proyección simulada, no un EEG real)
Esquema del cerebro (no es una resonancia): cada número es una zona; el color va de oscuro (poco) a blanco-amarillo (mucho), en una escala de 0 a 10 que es el máximo que alcanzó esa zona en la pieza simulada. La tabla dice qué cosa de la pieza encendió cada zona y en qué segundo.
Las zonas profundas (amígdala, hipotálamo, tálamo, accumbens, locus cerúleo) se infieren por regla a partir de lo que se ve; un modelo hecho solo con video no las puede predecir.
| N.º | Zona | Máximo (0 a 10) | Segundo del máximo | Lo que más la encendió | Para qué sirve |
|---|---|---|---|---|---|
| 1 | Visión Corteza visual (V1 a V4) | 8,4 | 16,3 | lo que entra por los ojos | Recibe lo que entra por los ojos: contraste, color, bordes y cambios de luz. |
| 6 | Palabra escrita Área de la palabra escrita (fusiforme izquierdo) | 8,2 | 10,4 | el mensaje «y esperar» | Reconoce las letras y las palabras escritas. |
| 2 | Movimiento Área del movimiento (MT/V5) | 7,9 | 32,3 | el movimiento | Detecta lo que se mueve y hacia dónde. |
| 8 | Lenguaje (temporal) Temporal superior izquierdo posterior (Wernicke) | 7,5 | 10,4 | el mensaje «y esperar» | Entiende el significado de las palabras, leídas u oídas. |
| 3 | Objetos Área de objetos (LOC) | 7,4 | 13,7 | un objeto: brackets inferiores | Reconoce objetos: el producto, el logo, las cosas. |
| 27 | Orden de mirar Colículo superior (tronco) | 7,3 | 35,7 | un movimiento repentino | Ejecuta el salto de los ojos hacia lo que el mapa de prioridad eligió. |
| 4 | Caras Área de las caras (fusiforme derecho) | 7,0 | 35,7 | una cara (sonrisa) mirando a cámara | Reconoce rostros; responde menos a una cara de cabeza. |
| 23 | Memoria y novedad Hipocampo | 6,8 | 35,7 | algo nuevo | Decide qué se guarda: lo nuevo y lo emocional se graba mejor. |
| 5 | Mirada y mente ajena Surco temporal superior y unión temporoparietal (derecha) | 6,7 | 1,5 | una cara (molestia) | Sigue la mirada y los gestos de otra persona y entiende lo que intenta; reorienta la atención tras un corte. |
| 11 | Campo ocular Campo ocular frontal | 6,7 | 35,7 | un movimiento repentino | Junto con el parietal decide el próximo salto de los ojos. |
Las otras 13 zonas
| N.º | Zona | Máximo (0 a 10) | Segundo del máximo | Lo que más la encendió | Para qué sirve |
|---|---|---|---|---|---|
| 18 | Emoción y relevancia Amígdala | 6,5 | 35,7 | una cara (sonrisa) mirando a cámara | Marca lo emocionalmente relevante: caras con emoción, miradas, amenaza, algo valioso. |
| 7 | Lenguaje (frontal) Frontal inferior izquierdo (Broca) | 6,2 | 10,4 | el mensaje «y esperar» | Arma y sigue el lenguaje: frases, ritmo de lectura. |
| 16 | Conflicto y esfuerzo Cíngulo anterior | 5,7 | 31,4 | varias cosas compitiendo por la atención | Avisa cuando hay conflicto o mucho que atender a la vez; también responde al dolor ajeno. |
| 10 | Atención y números Parietal (surco intraparietal) | 5,6 | 35,7 | un movimiento repentino | Arma el mapa de prioridad (a dónde mirar) y procesa cantidades como los precios. |
| 12 | Acción y manos Premotora (uso con la mano) | 5,2 | 35,0 | el llamado a la acción «ORTODONCIA» | Prepara la acción: ver un objeto que se usa con la mano o una orden de actuar la enciende. |
| 15 | Relevancia personal Prefrontal medial | 5,1 | 10,5 | el mensaje «y esperar» | Marca lo que me importa a mí; se enciende cuando el mensaje habla de mi situación. |
| 21 | Anticipación del premio Núcleo accumbens y área tegmental ventral | 5,1 | 2,6 | el mensaje «por miedo a verte mal?» | Se enciende al anticipar un premio (la promesa, la oferta, lo que viene), no tanto al recibirlo. |
| 20 | Sensación del cuerpo Ínsula | 5,0 | 2,8 | una cara (molestia) | Siente el cuerpo: molestia, dolor, asco; también el costo percibido. |
| 25 | Estado del cuerpo Hipotálamo | 4,7 | 35,7 | la emoción hecha cuerpo | Traduce la emoción en cuerpo: pulso, hambre, estrés. |
| 28 | Alerta Locus cerúleo (tronco) | 4,4 | 27,6 | un corte | Sube la alerta (y la pupila) ante cortes, ruidos y sorpresas. |
| 24 | Lugares Área de lugares (parahipocampo) | 4,3 | 16,3 | lo que entra por los ojos | Reconoce el lugar o escenario donde ocurre la escena. |
| 26 | Relevo de la atención Tálamo (pulvinar) | 3,7 | 27,6 | un corte | Reparte la señal de los sentidos; el pulvinar ayuda a elegir qué atender. |
| 13 | Meta y control Prefrontal dorsolateral | 2,4 | 12,0 | la meta de quien mira | Sostiene la meta (qué busco) y filtra lo que distrae; pesa poco cuando solo se desliza el feed. |
Actividad simulada por grupo de zonas, segundo a segundo (las líneas punteadas son cortes)
Lo que se vería en el cuero cabelludo
Qué se vería en 32 electrodos del cuero cabelludo si el cerebro simulado hiciera lo que la simulación dice. No son ondas medidas ni dibujadas de adorno: es cuánta actividad "se vería" desde cada electrodo. Rojo y amarillo: más actividad que el promedio de la pieza; azul: menos. La nariz está arriba; izquierda y derecha son las de la persona (T7, P7 a la izquierda; T8, P8 a la derecha).
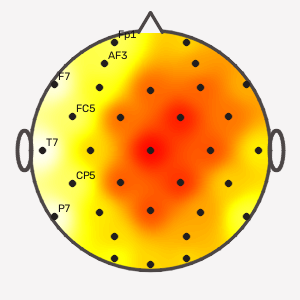
Causa: una cara (neutral).
Más arriba del promedio en T7, P7, F7.
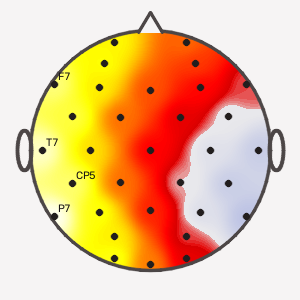
Causa: el subtítulo «diente se mueve».
Más arriba del promedio en P7, T7, F7.
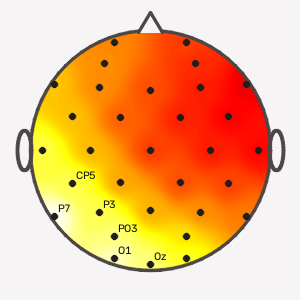
Causa: un movimiento repentino.
Más arriba del promedio en P7, O1, PO3.
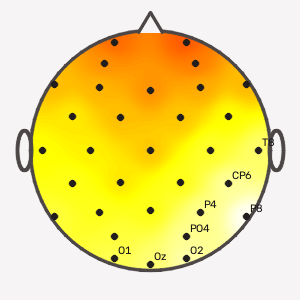
Causa: una cara (sonrisa) mirando a cámara.
Más arriba del promedio en P8, O2, CP6.
Actividad estimada por región de la cabeza (la línea punteada es el alfa occipital, el inverso de la actividad visual del modelo)
Marcas que se esperarían en un registro real
En un registro real estas marcas solo se ven promediando muchas repeticiones; aquí se listan con su causa, no se dibujan.
| Segundo | Marca | Causa | Qué se esperaría |
|---|---|---|---|
| 0,0 | N170 (respuesta a caras) | apareció una cara | en un registro real, unos 170 ms después de que aparece la cara, con tendencia a ser más fuerte en P8 que en P7 |
| 0,0 | N170 de palabra escrita | apareció «DIOSALUD» | en un registro real, unos 170 ms después de que aparece un texto, con tendencia a la izquierda |
| 0,6 | N170 de palabra escrita | apareció «ORTODONCIA» | en un registro real, unos 170 ms después de que aparece un texto, con tendencia a la izquierda |
| 3,8 | N170 (respuesta a caras) | apareció una cara | en un registro real, unos 170 ms después de que aparece la cara, con tendencia a ser más fuerte en P8 que en P7 |
| 9,1 | P300 (novedad) | hubo un corte | en un registro real, entre 300 y 500 ms después de algo nuevo, en la línea media |
| 9,2 | N170 de palabra escrita | apareció «y esperar» | en un registro real, unos 170 ms después de que aparece un texto, con tendencia a la izquierda |
| 12,3 | P300 (novedad) | hubo un corte | en un registro real, entre 300 y 500 ms después de algo nuevo, en la línea media |
| 16,3 | P300 (novedad) | hubo un corte | en un registro real, entre 300 y 500 ms después de algo nuevo, en la línea media |
| 17,9 | N170 (respuesta a caras) | apareció una cara | en un registro real, unos 170 ms después de que aparece la cara, con tendencia a ser más fuerte en P8 que en P7 |
- Aproximación geométrica de cuánto se vería cada zona desde cada electrodo; no es un modelo calculado con una cabeza real.
- No se dibujan ondas: un registro real necesita promediar muchas repeticiones para ver estas marcas.
- Las zonas profundas (amígdala, hipocampo, accumbens) casi no se ven desde el cuero cabelludo en un EEG real.
- La curva alfa occipital es solo el inverso de la actividad de las zonas visuales del modelo, sin unidades ni línea base: no es una medición, y en un registro real el alfa no tiene un significado fijo.
- Los mapas muestran cuánto 'se vería' cada zona del modelo desde cada electrodo (implicación relativa), no voltajes; las marcas se listan con su causa pero esta simulación no tiene la resolución de tiempo de un registro real.
- Las zonas profundas (hipotálamo, tálamo, accumbens, locus cerúleo) se infieren por regla a partir de lo que se ve; un modelo hecho solo con video no puede predecirlas.
- Solo se listan las primeras 3 marcas de caras, textos, cortes.
- No se incluye: asimetría alfa frontal (no validada); gamma (solo prometedora para tráileres); ruido o parpadeos de adorno.
4. Qué se guardó en la memoria (codificación simulada)
Cuántos de los 30 espectadores simulados grabaron cada cosa y en qué zonas del cerebro se guarda. Se graba lo que se mira de frente, se lee completo y tiene emoción ligada. Es una hipótesis: solo una prueba de recuerdo a las 24 horas con 100 o más personas lo confirma.
| Qué | ¿Se guardó? | Espectadores | Zonas asociadas (tabla fija) | Nota |
|---|---|---|---|---|
| La marca DIOSALUD | No se guardó | 0 % | Objetos, Palabra escrita, Valor, Memoria y novedad, Hábito y valor aprendido | En promedio leyó el 15 % de las palabras; Mirar la marca ayuda a recordarla, pero no basta. |
5. Cuánto tiempo se quedaron
Cada espectador simulado se aburre cuando todo lo que ve ya lo vio; lo nuevo y lo emocional lo bajan. Cuando el aburrimiento pasa su límite, el túnel se abre y, si nada nuevo aparece, desliza y se va. Índice de 0 a 100 del modelo, sin calibrar: sirve para comparar versiones de una pieza, no para predecir cuánta gente se queda.
30 de 30 se quedaron hasta el final (índice 100 de 100; tiempo medio 35,7 s de 35,7 s). En el tramo del dato clave (segundos 0,4 a 3,8) se van 0 espectadores.
Nadie se fue antes del final en esta simulación.
6. Cuatro criterios que la simulación estima
Son cuatro criterios que se estiman a partir de la simulación. Aquí salen de la simulación y no cuentan en el veredicto de arriba.
| Estado | Criterio |
|---|---|
| Cumple hipótesis | Lo primero que se mira es lo importante en el 100 % de los espectadores simulados la primera parada cayó sobre la cara (se pide al menos 50 %); ojo: el modelo hace que casi todos miren primero el centro de la pantalla, así que esto dice si la cara está en el centro, no que atraiga la mirada; solo el 13 % la dirigió directo ahí sin pasar por el centro |
| No cumple hipótesis | La marca se mira de frente 0 % de los espectadores simulados miró la marca de frente al menos una vez (se pide al menos 50 %); mirar la marca ayuda, pero no basta para recordarla |
| Sin comprobar hipótesis | La gente se queda durante el dato clave en la simulación nadie se va antes del final (índice 100 de 100): el modelo no distingue esta pieza de otra y no hay estudio que mida el abandono dentro de un video vertical, así que no se puede decir si la gente se queda durante el dato clave |
| No cumple hipótesis | El pico de emoción no compite con el dato clave la emoción simulada llega a su máximo en el segundo 1,8 (lo que acababa de aparecer: una cara (neutral)); lo esperable es que llegue entre el segundo 21,4 y el 30,4; ese máximo coincide con el dato clave (el mensaje) y la emoción le quita atención |